کنار نام یک مدل تازه، امتیازهای زیادی میبینیم؛ اما معمولاً یک سؤال ساده بیپاسخ میماند: این آزمونها به چه زبانی انجام شدهاند؟ اگر کار ما خواندن یک متن فارسی و مقایسه جزئیات آن باشد، پاسخ این سؤال از هیجان رتبهبندی مهمتر میشود. معرفی MiniMax M3.1 Flash فرصت خوبی است تا فاصله میان ارزیابی عمومی مدل و نیاز مشخص یک کاربر فارسیزبان را دقیقتر ببینیم.
MiniMax در ۱۹ اکتبر ۲۰۲۶ عرضه رسمی M3.1 Flash را اعلام کرد. شرکت بر توان انجام کارهای چندمرحلهای، برنامهنویسی و کار با رایانه تأکید دارد و دسترسی از طریق API، طرح M Plan و MiniMax Code را معرفی میکند. API راه اتصال برنامهها به مدل است؛ در نتیجه، دسترسی از این مسیر با داشتن یک برنامه آماده برای هر کاربر یکسان نیست. شرکت انتشار وزنهای مدل، یعنی دادههای آموختهشده لازم برای اجرای آن، را به آینده موکول کرده است؛ پس نباید عرضه فعلی را مجوز ادعای اجرای محلی مدل دانست. معرفی رسمی، ۱۹ اکتبر
ابتدا زبانِ کارنامه را بخوانیم
ارزیاب مستقل Artificial Analysis برای این مدل صفحهای شامل سنجش توانایی، مشخصات و هزینه دارد. این صفحه، شاهدی جدا از تبلیغات سازنده فراهم میکند؛ بااینحال، نوع آزمون همچنان مهم است. روششناسی همین ارزیاب میگوید شاخص اصلی آن عمدتاً متنی و انگلیسی است و ارزیابی چندزبانه و ورودی تصویری جدا انجام میشود. بنابراین وجود امتیاز در شاخص اصلی، بهخودیخود نتیجه آزمون فارسی نیست. روششناسی شاخص و محدودیت زبان
این تفاوت را میتوان با امتحان یک مهارت در شرایط مشخص فهمید. موفقیت در خواندن چند سند انگلیسی، اطلاعاتی درباره توان مدل میدهد؛ اما برای قضاوت درباره سند فارسی، هنوز باید خود آن موقعیت بررسی شود. از این فاصله نباید نتیجه معکوس هم گرفت: آزمودهنشدن یک کاربرد در شاهدی که داریم، اثبات ناتوانی مدل در آن کاربرد نیست. نتیجه دقیقتر این است که برای آن ادعا هنوز شاهد کافی نداریم.
همچنین یک شاخص ترکیبی از چند نوع مسئله ساخته میشود. کاربری که فقط میخواهد شرایط سه پیشنهاد را مقایسه کند، الزاماً همان ترکیب مهارتها را نیاز ندارد. به همین دلیل، این مقاله رتبه عمومی را به توصیه قطعی برای استفاده فارسی تبدیل نمیکند. ما مدل را در این کار آزمایش نکردهایم؛ آنچه در ادامه میآید، طرح یک بررسی محدود و قابل فهم است، نه گزارش نتیجه واقعی MiniMax.
سه بروشور فرضی، یک سؤال مشخص
فرض کنیم سه بروشور فارسی برای گردش یکروزه داریم و میخواهیم شرایط آنها را مقایسه کنیم. یکی ساعت حرکت را با رقم فارسی نوشته، دیگری همان اطلاعات را با رقم لاتین آورده و سومی درباره زمان برگشت چیزی نگفته است. هدف اولیه انتخاب «بهترین سفر» نیست. فقط میخواهیم بدانیم در هر سند چه اطلاعاتی وجود دارد و کدام مورد هنوز باید از برگزارکننده پرسیده شود. این مثال کاملاً تألیفی است و به پیشنهاد واقعی سفر اشاره ندارد.
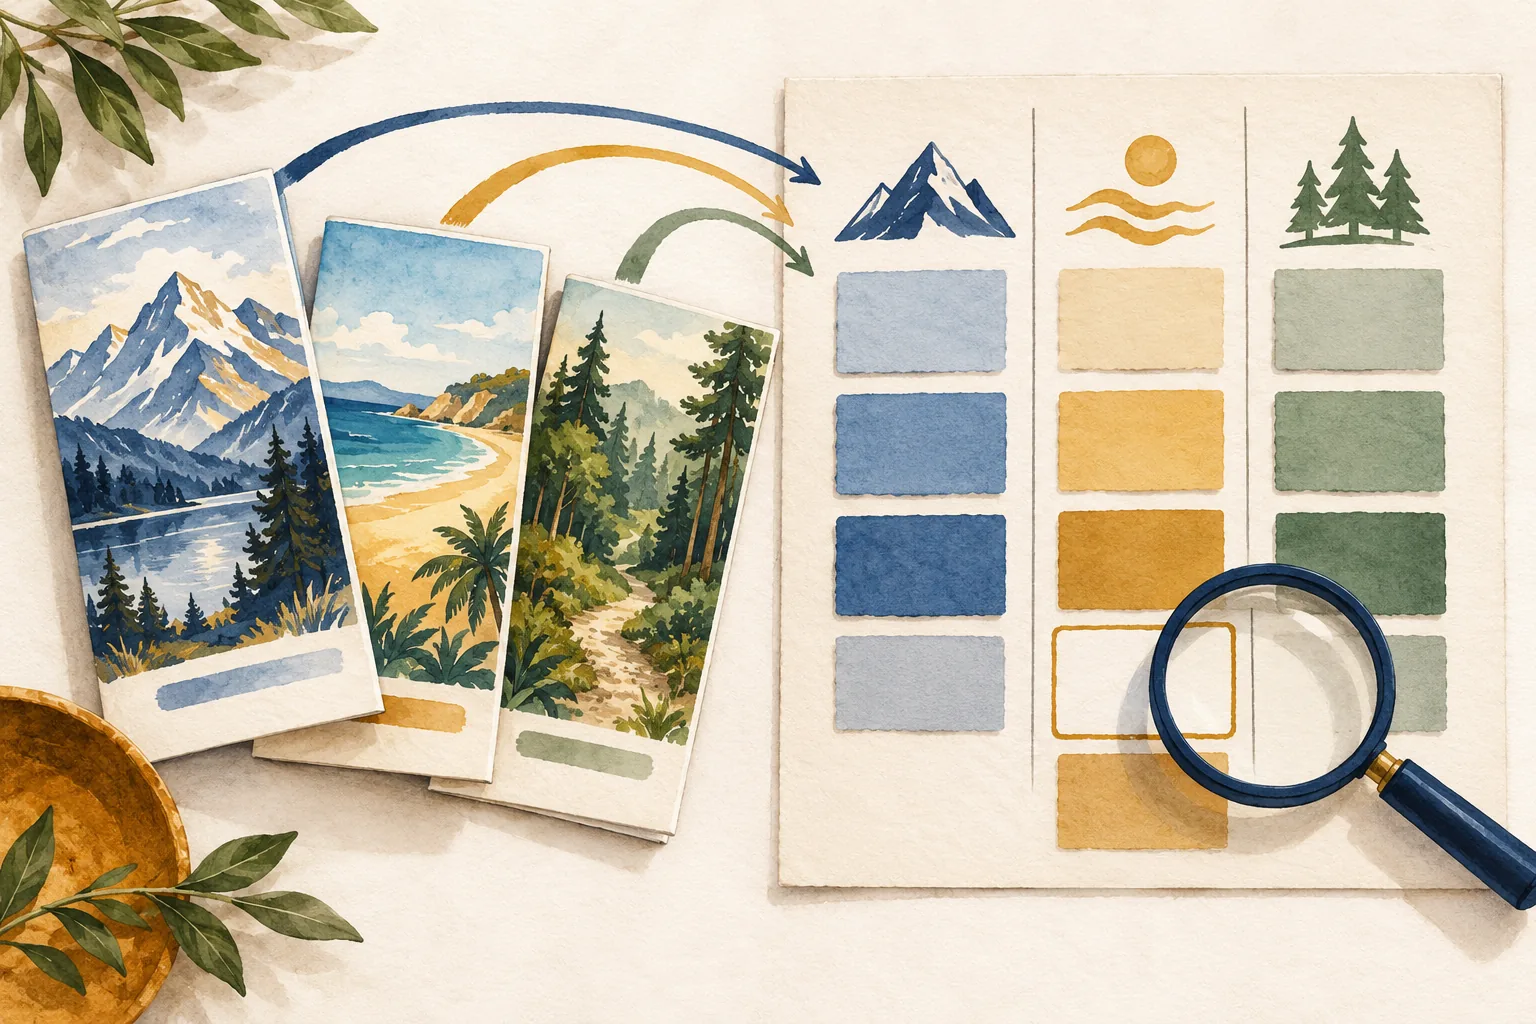
دستور پیشنهادی میتواند چنین باشد: «فقط از همین سه متن استفاده کن. ساعت حرکت، زمان برگشت و شرایط لغو را برای هر پیشنهاد جدا بنویس. کنار هر مورد، عبارت پشتیبان را از همان متن بیاور. اگر اطلاعاتی وجود ندارد، بنویس در سند ذکر نشده است.» این دستور برای روشنکردن انتظار ماست؛ اجرای آن روی مدل تازه در این مقاله انجام نشده و موفقیتش تضمین نمیشود.
پیش از دیدن پاسخ، خودمان پاسخ مرجع کوتاهی آماده کنیم. در این نمونه، مرجع باید نشان دهد کدام سند زمان برگشت ندارد و شرط لغو در کدام جمله آمده است. اگر معیار را پس از دیدن پاسخ بسازیم، ممکن است ظاهر مرتب جدول نظرمان را عوض کند و خطای مهم را کوچک بشماریم. آمادهکردن مرجع، روشی پیشنهادی برای منصفانهترشدن همین بررسی شخصی است؛ آن را آزمون استاندارد علمی معرفی نمیکنیم.
تغییر کوچک، پرسش دقیقتر
پس از بررسی نسخه اول، میتوان یک نسخه هممعنا از همان ورودی ساخت که فقط شکل رقمها در آن تغییر کرده باشد. اطلاعات، ترتیب اسناد و درخواست ثابت میمانند. اگر نتیجه عوض شود، سرنخی داریم که باید بررسی شود؛ هنوز علت قطعی را نمیدانیم. شاید مشکل در خواندن رقم، پیروی از دستور یا نوسان پاسخ باشد. برای نسبتدادن خطا به زبان فارسی، باید توضیحهای دیگر را هم در نظر گرفت.
در مرحلهای جدا میتوان یک جمله شرطی را سادهتر نوشت، بدون تغییر معنای آن. مثلاً «در صورت اعلام تا عصر روز قبل، امکان لغو وجود دارد» را به «اگر تا عصر روز قبل اطلاع بدهید، میتوانید لغو کنید» تبدیل کنیم. اگر پاسخ در یکی شرط را حذف کند، مسئله روشنتری برای پیگیری داریم. تغییر همزمان نامها، رقمها و جملهها بررسی را مبهم میکند، چون دیگر معلوم نیست تفاوت نتیجه به کدام تغییر مربوط بوده است.
مزیت این روش پیشنهادی، تولید یک برنده عمومی نیست؛ مشخصکردن محل خطاست. خروجی ممکن است ساعتها را درست استخراج کند اما شرط لغو را ناقص بنویسد. در این صورت جمله «مدل فارسی را بلد نیست» بیش از شواهد ما ادعا میکند. عبارت دقیقتر این است که در نمونه بررسیشده، شرط یک جمله در پاسخ حفظ نشده است. همین توصیف محدود برای اصلاح درخواست یا انتخاب بخش نیازمند بازبینی مفیدتر است.
مدل، برنامه و سند را از هم جدا کنیم
صفحه Artificial Analysis، ورودی متن و تصویر و خروجی متن را برای M3.1 Flash ذکر میکند. این مشخصات با تضمین خواندن هر فایل اسکنشده یا هر جدول فارسی برابر نیست. مشخصات و ارزیابی مستقل مدل اگر بروشور عکس کمکیفیتی باشد، نتیجه به خوانایی ورودی هم وابسته میشود. برای تمرین اولیه میتوان متن تایپشده و غیرحساس را انتخاب کرد تا مسئله خواندن تصویر با مسئله فهم جمله مخلوط نشود.
نام مدل نیز همه شرایط تجربه را توضیح نمیدهد. برنامهای که فایل را دریافت میکند، شیوه ارسال محتوا و دستورهایی که به مدل داده میشوند باید در یادداشت بررسی مشخص باشند. اگر یک بار متن کامل و بار دیگر فقط بخشی از آن ارسال شده باشد، تفاوت پاسخ را نمیتوان صرفاً به مدل نسبت داد. اینجا هدف، ثبت حداقل اطلاعاتی است که کمک کند بعداً بفهمیم دقیقاً چه چیزی را مقایسه کردهایم.
برای کاربر فارسیزبان، دسترسی و کیفیت دو پرسش جدا هستند. در منابع بررسیشده، کیفیت این سناریوی فارسی و امکان استفاده از ایران برای ما تأیید نشده است. اعلام عرضه جهانی یا وجود صفحه محصول، پاسخ خودکار این دو پرسش نیست. تا زمانی که شرایط استفاده و نتیجه واقعی روشن نباشد، مقاله را باید راهنمای خواندن شواهد و طراحی بررسی دانست، نه توصیه خرید اشتراک.
نتیجه خوب، محدوده خودش را هم میگوید
پس از چند اجرای محدود، بهتر است نتیجه را با نام نسخه، نوع ورودی و موارد درست و نادرست بنویسیم. مثلاً بگوییم «در متنهای انتخابشده، ساعت حرکت درست استخراج شد، اما شرط لغو نیاز به اصلاح داشت.» چنین نتیجهای درباره همان نمونههاست و به همه اسناد فارسی تعمیم ندارد. حتی اگر همه پاسخها درست باشند، نمونه کوچک هنوز نماینده تمام کاربردها نیست.
خبر MiniMax M3.1 Flash یک گزینه تازه به فهرست مدلها اضافه کرده است. برای استفاده روزمره، قدم بعدی میتواند کوچکتر و دقیقتر از دنبالکردن رتبهها باشد: یک کار روشن، ورودی معلوم و مرجعی که خودمان بتوانیم بررسی کنیم. اگر خانه «زمان برگشت» واقعاً در سند خالی است، حفظ همان جای خالی شاید از هر پاسخ پرجزئیاتتری ارزشمندتر باشد؛ چون مرز دانسته و نادانسته را برای تصمیم بعدی نگه میدارد.
هر دو تصویر با هوش مصنوعی تولید شدهاند و تصویرسازی مفهومیاند؛ شخص تصویر واقعی نیست و تصاویر، رابط یا نتیجه آزمون MiniMax را نشان نمیدهند.
منابع
- MiniMax: معرفی M3.1 Flash؛ ۱۹ اکتبر ۲۰۲۶؛ منبع رسمی عرضه و قابلیتهای ادعاشده.
- Artificial Analysis: ارزیابی MiniMax M3.1 Flash؛ مشاهده در ۲۰ اکتبر ۲۰۲۶؛ ارزیابی مستقل با شرایط مشخص.
- Artificial Analysis: روششناسی ارزیابی هوش؛ نسخه مشاهدهشده در ۲۰ اکتبر ۲۰۲۶؛ توضیح زبان، ترکیب آزمونها و حدود تعمیم.
نظر شما چیست؟