گاهی صحنه یک عکس را دقیق به یاد داریم، اما نام فایل و تاریخ ثبتش را نه. دریاچه، چادر زرد و کوه پشت سر آن در ذهنمان ماندهاند؛ در گوشی فقط ردیفی از نامهای شبیه به هم میبینیم. این فاصله میان چیزی که انسان به یاد میآورد و چیزی که جستوجوی فایل میخواهد، کاربرد روزمره مهمی برای هوش مصنوعی ایجاد کرده است: جستوجو با توصیف محتوا.
گوگل در ۶ اکتبر ۲۰۲۶ مدل EmbeddingGemma 2 را معرفی کرد که متن، تصویر، صدا و ویدیو را برای جستوجو به نمایشهای عددی قابل مقایسه تبدیل میکند. مدل برای اجرا روی دستگاههای مصرفی طراحی شده است. این تاریخ، زمان معرفی اصلی است؛ منابع مقاله حاضر در ۷ اکتبر بررسی شدهاند. اطلاعیه گوگل درباره قابلیتهای محصول است، نه نتیجه آزمایش مستقل روی گوشی یا فایلهای فارسی ما.
بهجای نام فایل، چیزی را بگویید که به یاد دارید
نمونه چادر کنار دریاچه را به یک موقعیت فرضی تبدیل کنیم. از سفری چند ویدیو دارید و میخواهید همان لحظهای را پیدا کنید که چادر زرد در کنار آب دیده میشود. عبارت «ویدیوی سفر» دامنه بزرگی دارد؛ «چادر زرد کنار دریاچه» نشانههای مشخصتری به جستوجو میدهد. در اینجا هدف ساختن تصویر تازه یا توصیف خیالپردازانه سفر نیست. میخواهیم از میان فایلهایی که واقعاً داریم، موارد مرتبط را پیدا کنیم.
گوگل این کاربرد را در دو نمونه تازه برنامه Google AI Edge Gallery نشان داده است. Instant Media Search برای جستوجوی رسانههای محلی با متن یا تصویر نمونه است. Video Moments Finder به پیدا کردن لحظههای مرتبط در ویدیوی انتخابشده کمک میکند. بنا بر شرح رسمی نمونهها، پردازش و مقایسه در این تجربهها روی دستگاه انجام میشود و برنامه از فروشگاههای اندروید و iOS قابل دریافت است. اینها نمونههای نمایش و ارزیابی فناوریاند؛ نباید معرفی آنها را فعالشدن خودکار قابلیت در همه گالریهای گوشی دانست.
برای کاربر، تغییر اصلی در شیوه بیان درخواست است. لازم نیست حتماً عنوانی را که قبلاً روی فایل گذاشتهاید به یاد بیاورید. میتوانید از یک نشانه دیداری شروع کنید و پس از دیدن نتیجه، آن را دقیقتر کنید. بااینحال، توضیح باید درباره چیزی باشد که انتظار دارید در فایل دیده یا شنیده شود. خاطرهای مانند «سفر خیلی خوبی بود» ممکن است برای خودتان روشن باشد، اما نشانه مشخصی برای جدا کردن چند منظره مشابه به دست نمیدهد.
پشت جستوجو، یک نشانی عددی قرار دارد
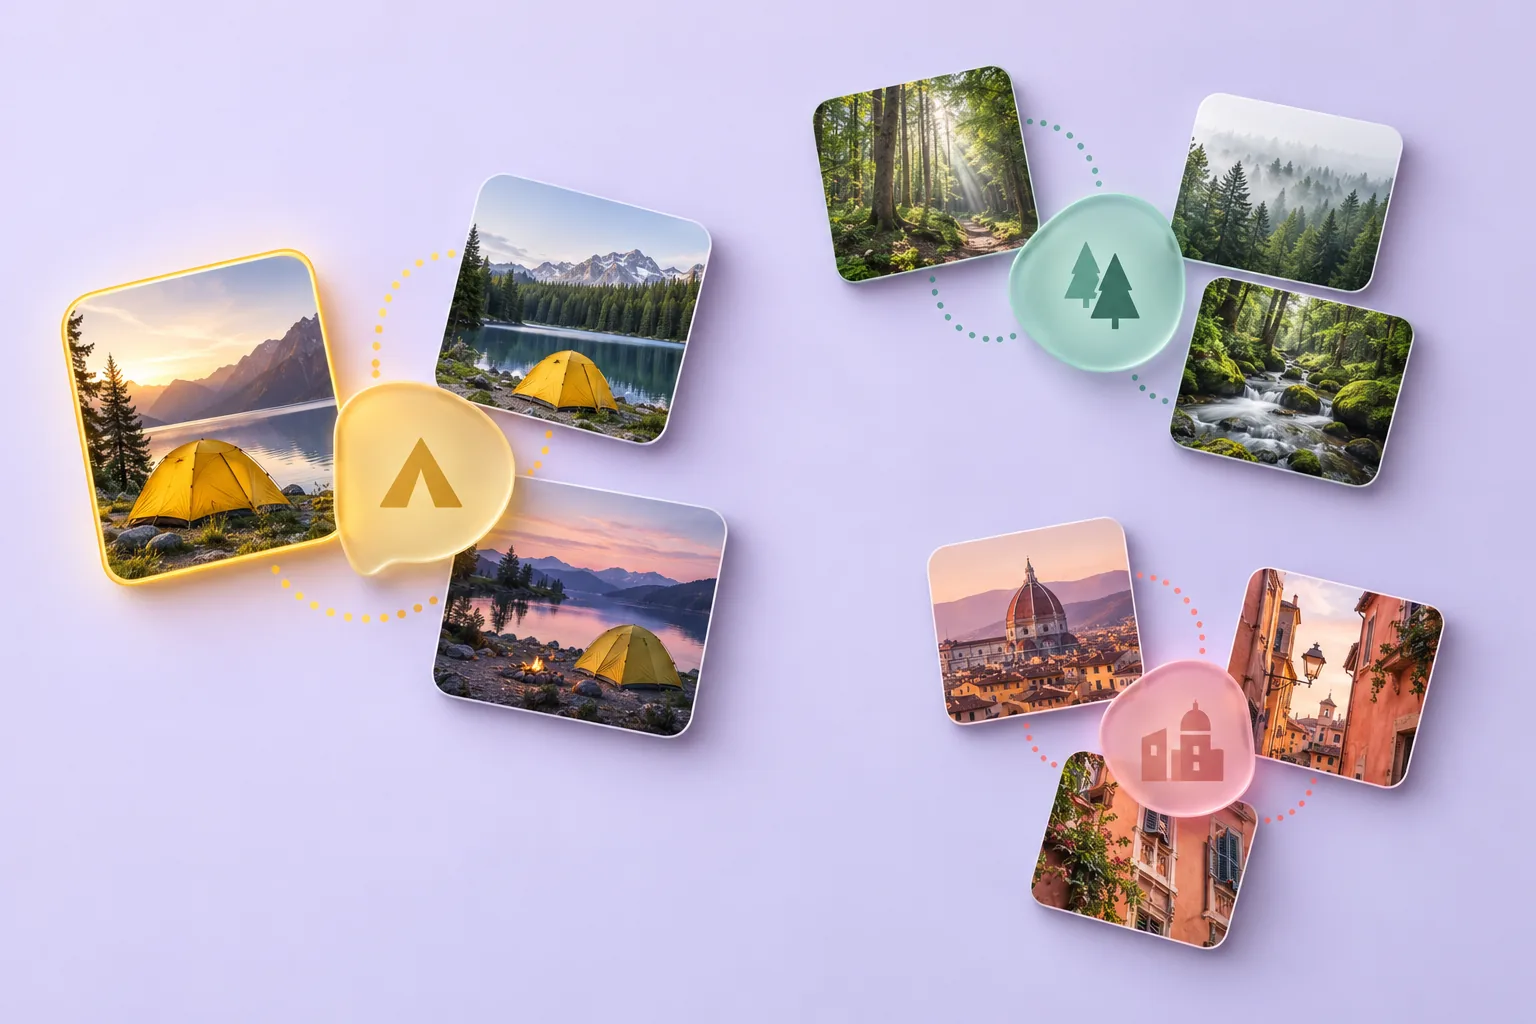
در راهنمای فنی مدل، خروجی مشترک برای رسانههای مختلف یک بردار ۷۶۸بعدی معرفی شده است. بردار در این بحث، فهرستی از عددهاست که ویژگیهای آموختهشده محتوا را نمایش میدهد. بخشهای تخصصی مدل ورودیهای متفاوت را پردازش میکنند، اما نتیجه در فضایی مشترک قرار میگیرد. به این نمایش عددی «امبدینگ» میگویند؛ قرار نیست کاربر آن عددها را بخواند یا برای هر فایل دستی برچسب بنویسد.
برای تصور آن، نقشهای آموزشی در نظر بگیرید که تصویرهای مرتبط در بخشهای نزدیک آن قرار دارند. پرسش شما نیز به نقطهای در همان نقشه تبدیل میشود و برنامه به دنبال همسایههای مناسب میگردد. این فقط تشبیهی برای فهم موضوع است؛ مدل واقعاً یک نقشه دوبعدی با محلههای نامگذاریشده ندارد. اهمیت تشبیه در این است که «نزدیک بودن» را از «یکسان بودن» جدا کنیم: دو عکس متفاوت میتوانند از نظر موضوع بسیار شبیه باشند.
مرحله آمادهسازی فایلها نیز مهم است. طبق توضیح Google AI Edge، نمونه جستوجوی رسانه، نمایشهای عددی فایلها را روی دستگاه میسازد و در پایگاه داده محلی نگه میدارد. سپس نمایش عددی پرسش با آنها مقایسه میشود. بنابراین جستوجو تنها خواندن جمله شما نیست؛ مجموعهای که در دسترس برنامه قرار گرفته باید برای بازیابی آماده شده باشد. این توضیح فنی را نباید وعده زمان آمادهسازی یکسان برای هر آرشیو و هر گوشی تعبیر کرد.
وقتی نتیجه شبیه است، ولی همان خاطره نیست
به سفر فرضی برگردیم. ممکن است اولین نتیجه، چادر زردی کنار دریاچهای دیگر باشد. از نظر ظاهر به پرسش میخورد، اما فایل مورد نظر شما نیست. در این وضعیت، جستوجو یک نامزد مناسب معرفی کرده و هنوز تشخیص نهایی باقی مانده است. باز کردن ویدیو، دیدن چند ثانیه قبل و بعد و بررسی تاریخ فایل میتواند کمک کند تفاوت را بفهمید. این پیشنهاد عملی ما برای بررسی نتیجه است، نه گزارشی از خطایی که در آزمایش این محصول دیده باشیم.
حتی نبودن نتیجه هم پاسخ قطعی درباره آرشیو نیست. شاید عبارت انتخابی مبهم باشد، فایل مورد نظر در مجموعه انتخابشده نباشد یا نمای مرتبط کوتاهتر از آن باشد که در پردازش دیده شود. کارت مدل توضیح میدهد که ویدیو در حالت پیشفرض با نمونهبرداری یک فریم در ثانیه پردازش میشود و این نرخ قابل تنظیم است. این مشخصه پیشفرض مدل را نباید بدون بررسی به همه برنامههای ساختهشده با آن نسبت داد.
تفاوت کیفیت میان زبانها هم باید جدی گرفته شود. همان کارت مدل با وجود پشتیبانی از بیش از صد زبان، عملکرد برابر در همه زبانها را وعده نمیدهد و ابهامهای زبان طبیعی را از محدودیتها میداند. برای این مقاله، دقت جستوجوی فارسی اندازهگیری نشده است. اگر درخواست فارسی نتیجه ضعیفی داد، نمیتوان از یک نمونه نتیجه گرفت کل فناوری بیفایده است؛ به همان اندازه هم نباید از یک پاسخ خوب، دقت همیشگی آن را نتیجه گرفت.
تمایز مهمتر این است که این مدل بهخودیخود پاسخ داستانی تولید نمیکند؛ خروجی آن نمایش عددی محتواست. ممکن است برنامهای در مرحله بعد از مدل دیگری برای نوشتن پاسخ استفاده کند. در آن صورت، پیدا شدن یک فایل و درست بودن توضیح نوشتهشده درباره آن دو موضوع جدا هستند. برای کاربرد ما، دیدن فایل اصلی ارزشمندتر از متنی روان است که معلوم نیست به کدام بخش آرشیو تکیه دارد.
یک پوشه کوچک، پیش از سپردن کل آرشیو
اگر برنامه و مدل روی دستگاهتان در دسترس بود، میتوانید از چند فایل غیرحساس شروع کنید که محتوایشان را خوب میشناسید. در مجموعه فرضی ما، یک عکس چادر کنار آب، یک عکس چادر در جنگل و یک منظره دریاچه بدون چادر وجود دارد. این انتخاب کمک میکند بفهمیم جستوجو به کدام بخش توضیح توجه میکند. قرار نیست با این تمرین محدود، رتبه علمی مدل یا دقت آن برای همه کاربران تعیین شود.
ابتدا عبارتی کلی بنویسید و سپس فقط یک ویژگی قابل مشاهده به آن اضافه کنید. بررسی کنید آیا ترتیب نتایج به سمت فایل مورد نظرتان تغییر میکند. اگر نشد، موارد را یادداشت کنید: رنگ نادیده گرفته شده، موضوع اصلی درست پیدا شده ولی محل متفاوت است، یا فایل اصلاً در مجموعه انتخابی نیست. چنین یادداشتی از عبارت کلی «خوب کار نمیکند» اطلاعات بیشتری میدهد و کمک میکند محدودیت ابزار را در استفاده خودتان بشناسید.
اجرای محلی مدل نیز با خصوصی بودن تمام مسیر نگهداری فایل یکسان نیست. ممکن است همان پوشه از راه برنامه دیگری پشتیبانگیری ابری شود. پیشنهاد ما این است که دسترسی برنامه به رسانهها و تنظیمات همگامسازی دستگاه را جدا بررسی کنید. همچنین کارکرد آفلاین پس از آمادهسازی، به معنی بینیازی از اینترنت برای دریافت اولیه برنامه و مدل نیست. دسترسی عملی از ایران و سازگاری یک گوشی مشخص در این گزارش آزمایش نشده است.
نتیجه مفید این جستوجو باید چیزی قابل بازبینی باشد: همان عکس یا همان لحظه ویدیو که میتوانید بازش کنید و بشناسید. اگر ابزار فاصله میان «صحنهای که یادم مانده» و «فایلی که پیدایش کردهام» را کم کند، یک کار روزمره را سادهتر کرده است. معیار را همین نگه دارید؛ پاسخ اول را ببینید، با نشانههای واقعی تطبیق دهید و اگر لازم بود توضیح جستوجو را اصلاح کنید.
تصویر شاخص، تصویرسازی مفهومی تولیدشده با هوش مصنوعی از جستوجوی عکس سفر است؛ عکس واقعی یک رویداد یا رابط Google AI Edge Gallery نیست.
نظر شما چیست؟